AI 教程AI教程271 次浏览 · 2026-10-12
本地低配流畅运行125B大模型 Stia三级调度框架实战指南
原文链接
https://youtu.be/jkXVueVhU_M?is=CvqEjhsdt5F1Bt8V一、核心概述
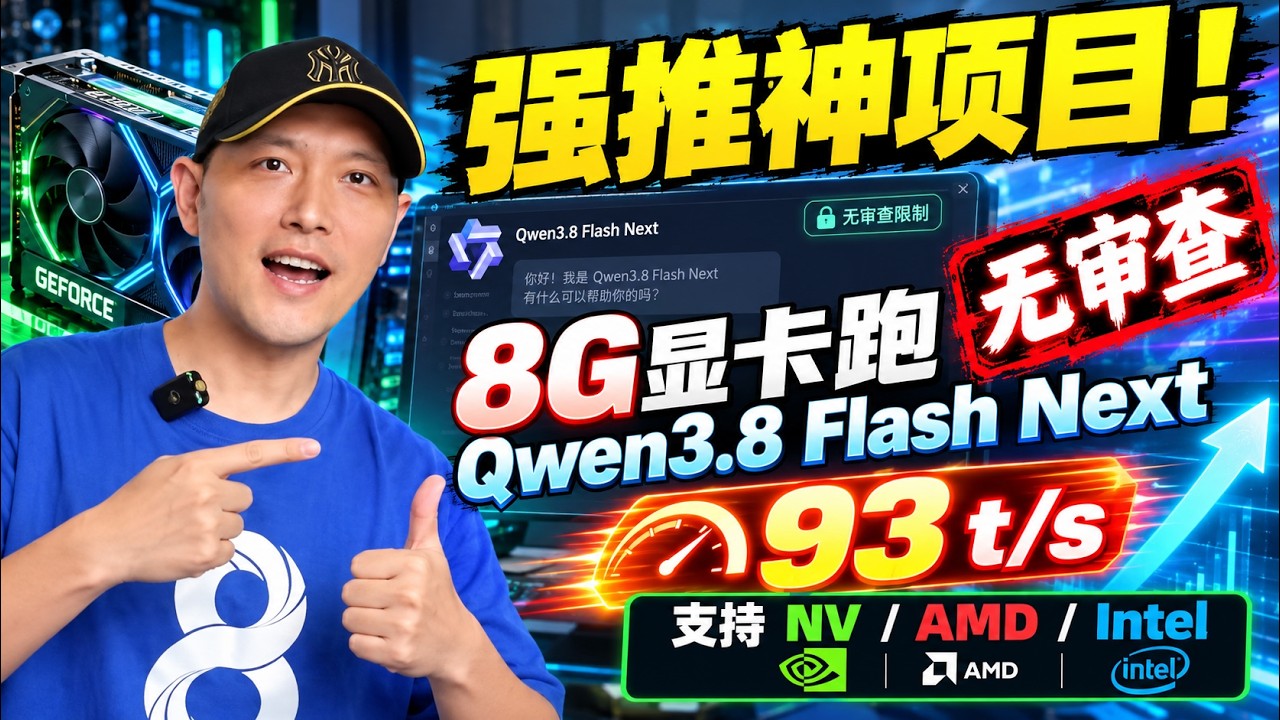
在传统的本地大模型部署中,运行百亿级别(如 125B 参数量级)的百亿/千亿级 MoE 模型往往需要昂贵的高端服务器级显卡。开源 MoE 推理框架 Stia 通过 显存 (VRAM) + 内存 (RAM) + 固态硬盘 (SSD) 的三级异构存储调度机制,大幅降低了超大参数模型的运行门槛。
核心功能与优势亮点:
- 低硬件门槛:普通消费级硬件(如 i5-12400 CPU + 64GB RAM + RTX 4060 16GB 显卡)即可本地流畅运行 125B 级别的超大模型。
- 高性能输出:本地推理速度可达 30+ tokens/s,并支持高达 128K 的长上下文窗口,轻松应对复杂 Agent 任务。
- 跨平台兼容:适配 NVIDIA(30/40/50 系列及老旧 T10 显卡)、AMD(HIP 架构)以及 Intel 显卡。
- 隐私安全与无限制:数据完全停留在本地,无需上传云端,同时支持运行无审查(Uncensored)模型。
二、实操步骤与核心流程详解
1. 环境准备与模型文件整合
- 存储规划:由于 125B 模型体积较大,需在本地硬盘预留至少 100GB - 300GB 的可用空间。
- 下载与归档:将 Stia 项目文件以及所需量化模型文件(如 IQ3_XS、Q3、Q1 等版本)下载至本地,并统一存放在同一个新建文件夹中。
- 提示:无需下载所有量化版本,根据显卡配置选择 1-2 个合适版本(如 16GB 显卡优先选 IQ3_XS 或 XS 版)即可。
2. 利用 AI Agent 进行全自动代码部署
- 打开 Agent 编码工具(如 Wbody 或 DeepSeek Harness)。
- 复制项目及模型所在的本地路径,向 Agent 发送指令:
“请帮我部署此路径下的项目,并配置好目录下内置的大模型。”
- Agent 会自动处理依赖安装、环境配置与启动服务。部署完成后,Agent 将直接提供访问 URL 链接。
3. Web UI 访问与多模型动态切换配置
- 点击 Agent 返回的 Web UI 链接即可进入精致的聊天交互界面,开始本地长文本对话。
- 添加模型切换功能:若下载了多个模型版本,可直接向 Agent 提问并发送指令:
“当前目录存在多个模型,请帮我在 Web UI 对话页面中嵌入一个模型切换按钮/入口。”
- Agent 会自动重构 Web UI 代码并完成嵌入,几分钟内即可实现界面的无缝模型切换。
三、实战技巧与核心小结
- 显存与 Context Window 调优:
- 16GB 显存:可轻松开启 128K 上下文窗口,适合运行复杂的 Agent 智能体和长文本分析。
- 8GB 显存:可运行低量化版本(如 IQ3_XS),建议适当调小 Context Window 以防止显存溢出。
- 版本选型建议:
- NVIDIA 30/40/50 系新卡:优先选择项目中的
st版本,推理效率最高。 - 老旧显卡(如 T10):选择标记有
12的兼容版本。 - AMD 显卡:直接下载专为 AMD 优化的
HIP版本。
- NVIDIA 30/40/50 系新卡:优先选择项目中的
- 零基础部署提示:借助 AI Agent 工具处理部署流程,能够极大降低命令行配置与环境报错的技术门槛,实现真正的“一键式”本地大模型落地。