AI 教程AI教程110 次浏览 · 2026-10-15
打造个人 AI 内容引擎:全流程实战指南
原文链接
https://youtu.be/2i_ZyqDmtio?is=nX2yaXyXr8uiCPZk一、核心概述
本教程围绕 AI 内容引擎(又称 Second Brain)的搭建与使用展开,帮助你在信息爆炸的时代高效捕获、过滤、聚合 AI 领域的最新动态。核心痛点包括:
- 每周数十个新模型、工具、博客、GitHub 项目涌现,手动追踪成本极高;
- 大量噪声信息(fluff)占用阅读时间和 LLM 计算资源;
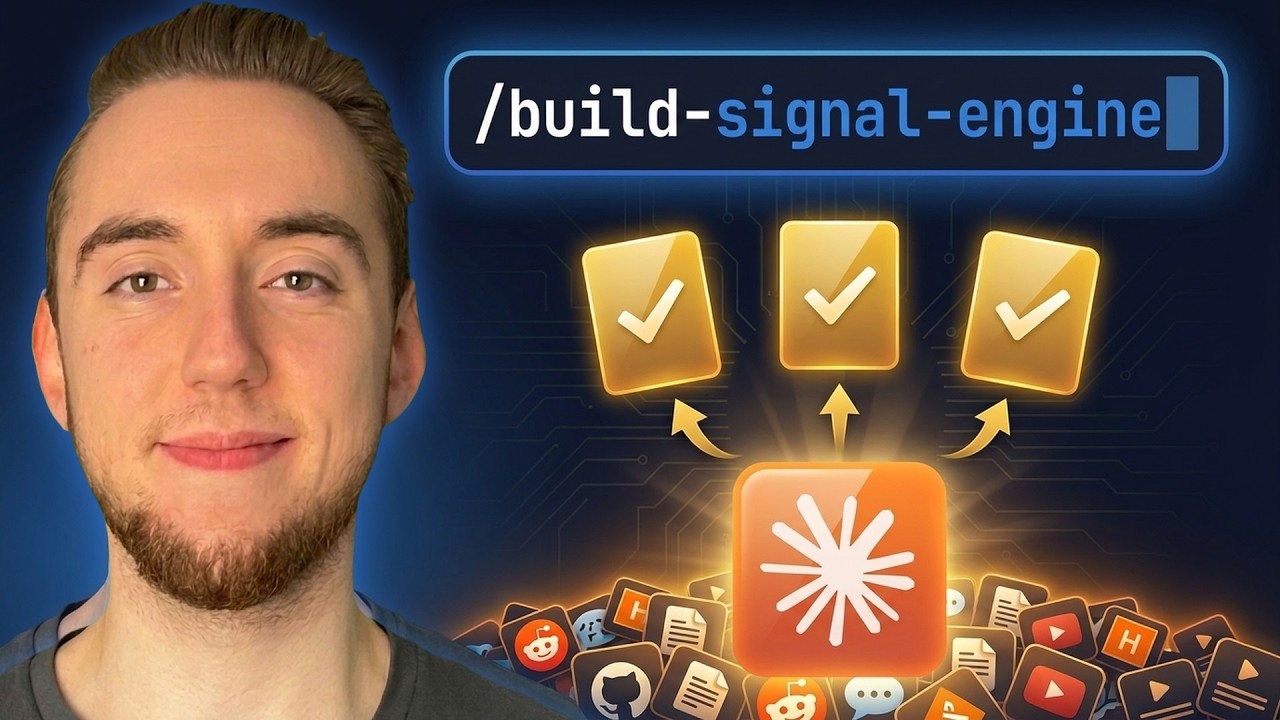
- 缺乏统一的 数据层 与 每日摘要,导致信息碎片化。 本系统通过 多源抓取 → 去重 → 确定性过滤 → LLM 细筛 → 摘要输出 的六步流水线,实现 低成本、低噪声、可定制 的每日 AI 新闻摘要。
二、实操步骤与核心流程详解
- 准备工作
- 在 GitHub 上 fork 我的
skills仓库,获取build_signal_engine技能。 - 推荐使用 Claude Code 插件或任意支持
agentic coding的平台(如 Cloud Code)。
- 在 GitHub 上 fork 我的
- 初始化项目
/build_signal_engine # 在空文件夹中执行,无需额外参数- 系统会自动弹出一系列问答(即“面试”),帮助你定义:
- 目标来源(Reddit、YouTube、RSS、Hacker News、GitHub、ChangeLog 等)
- 抓取方式(API、CLI、Appify 等)
- 过滤偏好(关注的主题、关注度阈值、是否为新内容)
- 系统会自动弹出一系列问答(即“面试”),帮助你定义:
- 构建数据层
- 根据你的回答,Skill 会生成统一的 JSON 配置文件,列出所有源的 URL、查询参数以及对应的抓取实现。
- 推荐使用 Appify:一站式连接上千种数据源,返回已去除冗余的 Markdown,省去自行清洗的步骤。
- 去重与确定性过滤
- 所有抓取的原始内容先写入中心数据库(如 SQLite 或 PostgreSQL),并记录唯一标识(URL+发布时间)。
- 去重:跳过已处理过的条目,避免 LLM 重复消耗 Token。
- 确定性过滤:
- 过滤 旧帖(超过设定天数)
- 过滤 低互动(观看/点赞/评论数低于阈值)
- 第一层模型筛选(Jev)
- 使用 Jev(轻量化分类模型)对剩余条目进行三维打分:
- 是否在主题范围
- 是否符合个人兴趣
- 是否为新颖、可落地的内容
- 打分低于 7 的直接丢弃,打分高且明确的直接保留,介于两者之间的交给后续 LLM 进一步判断。
- 使用 Jev(轻量化分类模型)对剩余条目进行三维打分:
- LLM 深度筛选 & 摘要生成
- 对交叉判定的条目调用 Claude Haiku 5.5(或同价位模型)进行语义理解与摘要。
- 生成的摘要结构统一为:标题、来源、关键要点、行动建议。
- 每日 Digest 输出
- 将所有通过 LLM 的摘要合并为 Markdown 日报,通过邮件、Slack 或自建网页推送。
- 系统自动记录本次运行的成本(示例:Jev 3¢,Claude Haiku 42¢),帮助你监控费用。
- 后期迭代
- Skill 会在项目根目录生成
profile.json,概览所有源、过滤规则与调度配置。 - 如需增删源或调整阈值,只需编辑该文件并让 Agent 再次执行
apply_profile即可。
- Skill 会在项目根目录生成
三、实战技巧与核心小结
- 提前清洗:即使使用 Appify,也建议在抓取后手动去除标题前缀、广告链接等冗余信息,降低后续模型负担。
- 成本控制:将 Jev 设为第一道防线,可将 LLM 调用次数压至 5% 以下;每日总费用通常不超过 0.5 美元。
- 阈值调优:初始时可将观看/点赞阈值设为 500,后续根据实际噪声水平逐步下调。
- 多平台备份:将抓取的原始 JSON 同步至云存储(如 S3),防止意外数据丢失。
- 持续迭代:每月回顾
profile.json,根据新出现的工具或渠道(如新兴的 AI 社区)及时加入。
核心结论:通过本套 AI 内容引擎,你可以在数分钟内完成数百条信息的抓取、去噪、筛选与摘要,显著提升信息获取效率,省下的时间可用于真正的创作与实验。