AI 教程AI教程56 次浏览 · 2026-10-20
LangChain Managed Deep Agents:实战教程
原文链接
https://youtu.be/TVhhmhvCovg?is=ebo1o3iSd7skYdKt一、核心概述
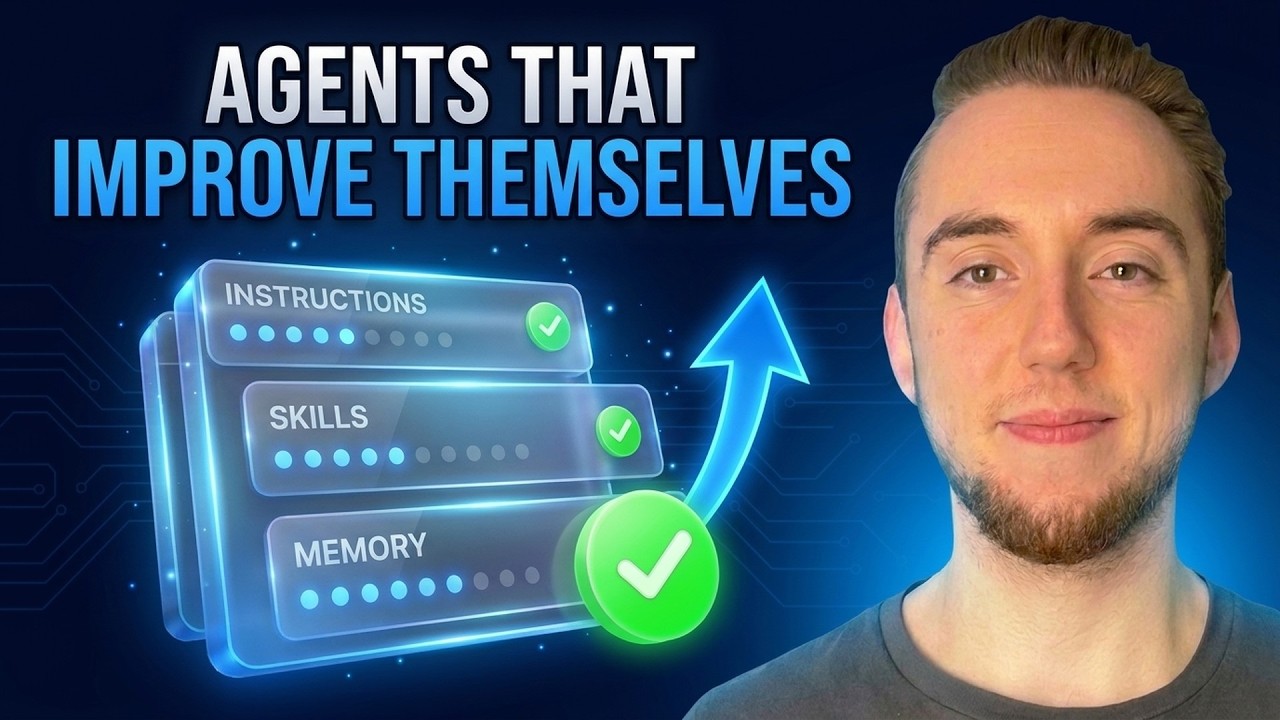
本节简要介绍 LangChain Managed Deep Agents 的定位与价值,以及在生产环境中进行 Harness Engineering(套索工程) 的核心思路。该平台把传统编码代理的全部“套索”(规则、工作流、记忆、守护钩子等)抽象为 Markdown 文档,实现 即插即用、可迭代 的部署方式。
- 痛点:传统代理把业务逻辑硬编码在代码里,迭代慢、可观测性差。
- 亮点:
- Markdown‑驱动:规则、技能、全局指令全部以
.md/.mmd文件管理,修改即生效。 - 双循环学习:
- 记忆循环:生产中捕获不确定/错误案例,写入 Context Hub(记忆库),实现 per‑user 学习。
- 套索循环:基于 LangSmith 追踪数据,自动生成规则/技能改进建议,人工审批后自动更新。
- 平台化:LangChain 提供 Managed Deep Agents 与 LangSmith 引擎,省去自行搭建追踪、CI/CD 流程的成本。
- Markdown‑驱动:规则、技能、全局指令全部以
本教程根据 YouTube 视频字幕整理,原始视频链接见原文出处。
二、实操步骤与核心流程详解
1. 项目结构约定
agent/
├─ agent.py            # 入口,仅 30 行代码
├─ instructions.mmd   # 全局系统指令(相当于 system prompt)
├─ skills/             # 各功能工作流,均为 Markdown
├─ memory/             # Context Hub,存放 per‑user 记忆与案例
└─ ...
- 将 instructions.mmd 放在根目录,平台会自动加载。
- skills 文件夹下每个
.md定义一个 Skill(即原先的工具函数)。 - memory 包含
cases/(不确定案例)和agents.mmd(全局学习规则)。
2. 创建 Agent(agent.py)
from langchain import ManagedDeepAgent

agent = ManagedDeepAgent(
    name="HelpDeskAgent",
    instructions_path="./instructions.mmd",
    skills_path="./skills",
    memory_path="./memory",
)
- 只需几行代码即可把所有 Markdown 绑定为完整代理。
- 代码中仍保留 guard rails(如 token 限制、调用频率)等必要的硬件防护。
3. 生产环境监控与记忆循环
- 不确定检测:在对话中,模型若返回 "I am not sure",自动在
memory/cases/生成一条记录。 - 人工介入:团队在 LangChain Dashboard 的 Inbox 中查看案例,提供正确答案。
- 写入记忆:系统将答案写入两处:
- per‑user memory(仅该用户可见)
- agents.mmd(全局规则),形成 Lesson。
- 检索策略:使用向量检索或 BM25,仅在需要时召回相关 Lesson,避免上下文膨胀。
4. 套索循环(规则迭代)
- 追踪数据:LangSmith 自动记录每一次调用的输入、输出、错误信息。
- 错误聚合:平台根据 trace 自动归类常见失误(如工具调用参数错误、指令冲突)。
- 建议生成:LangSmith Engine 提供 Proposed Fix,示例:
# 新增规则 - 当用户询问 "archon workflow" 且出现旧命令时,提示使用 `git push && archon run`。 - 人工审批:在 Dashboard 中点击 Apply,系统立即更新
instructions.mmd或对应 Skill。 - 版本管理:每次修改都会生成 Git‑style commit,支持回滚、分支、Promote。
5. 部署
- 通过 LangChain Managed Deep Agents 一键部署至 Slack、Discord、Webhook 等渠道。
- 部署后仍保持 Memory Hub 与 Trace Dashboard 在线,可随时监控与迭代。
三、实战技巧与核心小结
- 先跑小数据集:在正式上线前,用 10‑20 条真实问答跑通记忆循环,确保 Lesson 能被正确写入。
- 限制记忆规模:设置检索阈值(如 Top‑5),防止旧案例干扰新问题。
- 审慎使用自动修复:仅对 规则层面(system prompt、Skill)开启自动 Apply,工具层面的改动仍建议 PR 审核。
- 分离用户记忆:利用 per‑user memory 防止信息泄露,确保不同用户的私有上下文互不干扰。
- 监控指标:关注 Uncertainty Rate、Fix Acceptance Rate、Success@N,用这些 KPI 驱动下一轮套索工程。
核心结论:
- Harness Engineering 不是一次性工作,而是生产环境中持续的双循环迭代。
- LangChain Managed Deep Agents 把编码代理的最佳实践(Markdown‑驱动、双循环学习、可视化追踪)直接迁移到业务自动化代理。
- 通过 LangSmith 的 Trace 与建议引擎,团队可以在保持全权控制的前提下,实现 快速、低风险 的规则升级。
如需体验平台并获取 $50 额度,可使用代码 colem。祝你在生产环境中玩转 AI 代理!